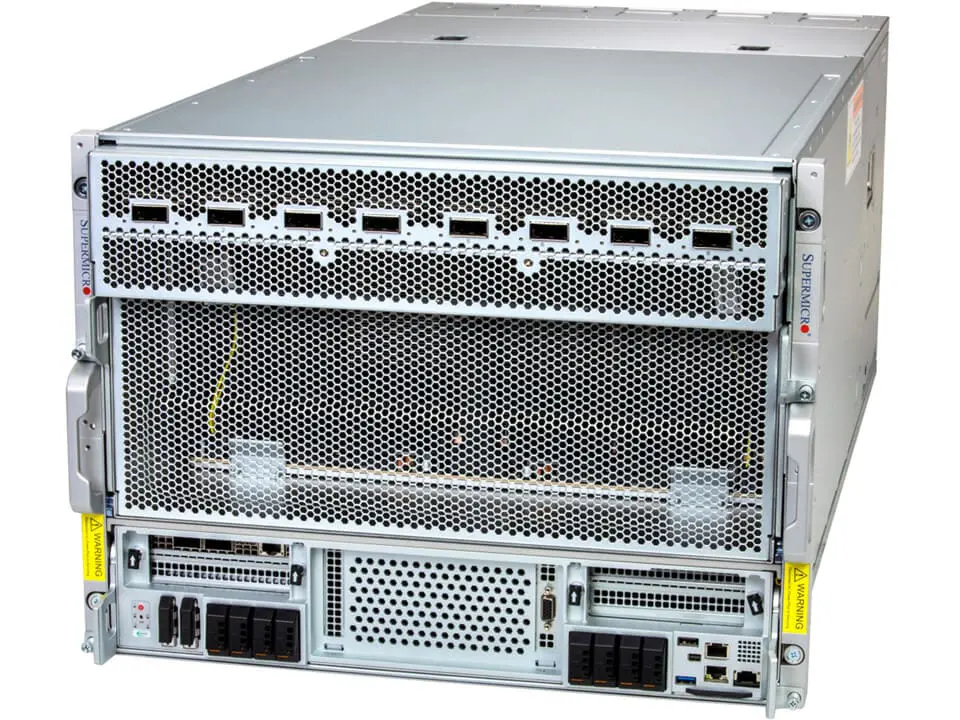
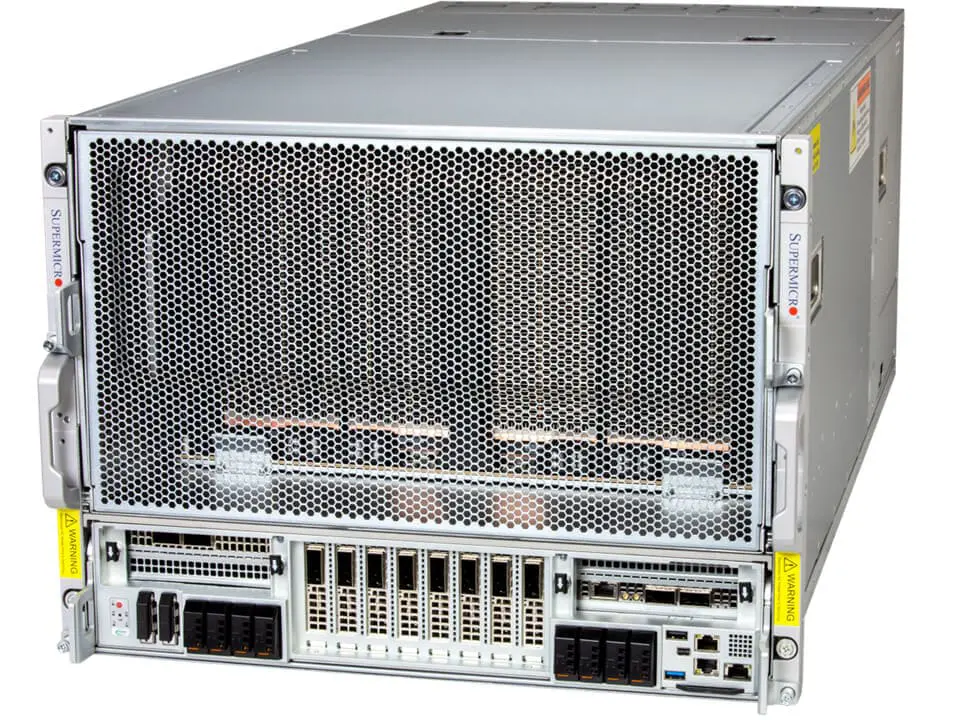
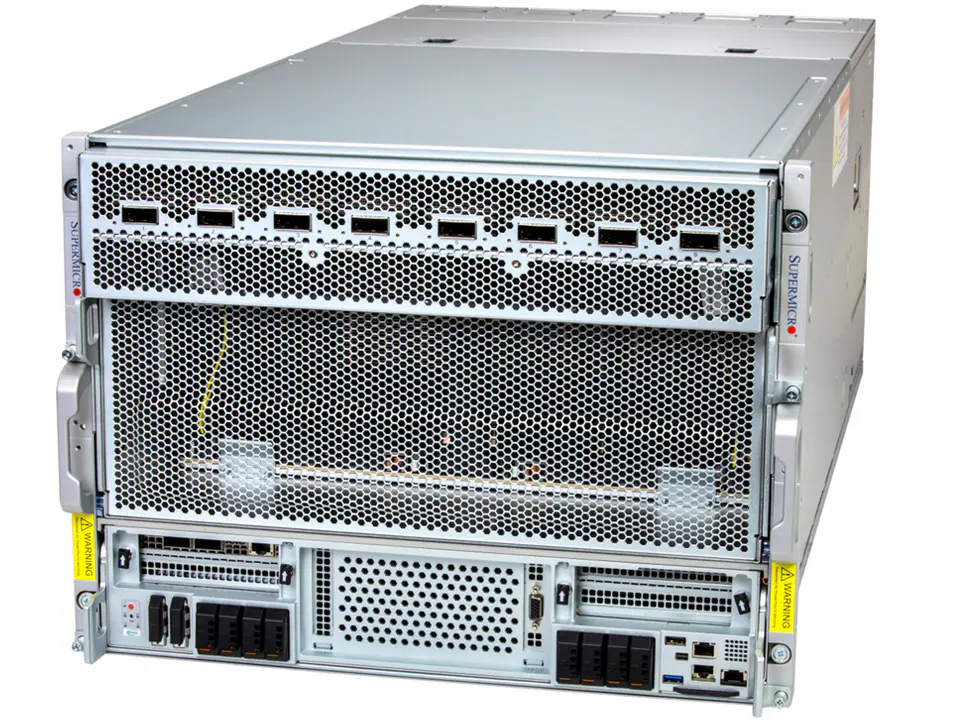
NVIDIA® HGX™ Blackwellは8基のNVIDIA Blackwell SXMを搭載した単一ベースボードです。BlackwellアーキテクチャをベースとしたNVIDIA HGX Blackwellは、前世代より大幅に強化されたAI性能を持ち最も要求の厳しい生成AI、データ分析、HPCワークロードに対応しています。
NVIDIA HGX システムは、GPUヒートシンクや高速ネットワークインターフェイスを含む主要コンポーネントを効率的に冷却する空冷システムとして設計されています。このシステムには、8基のNVIDIA Blackwell GPUが搭載されており、それぞれがHBM3eメモリを搭載しています。GPU同士は最新のNVIDIA NVLinkを通じて相互接続されGPUリソースの巨大なプールを作成、1つのAIスーパーコンピューターとして動作します。各GPUはそれぞれがNVIDIA ConnectX®-7 NICまたはBlueField®-3 SuperNICをサポートしたNICと接続され、高性能コンピュートファブリック全体でスケーリングします。
|
|
|
|
|---|---|---|
| フォームファクター | 8x NVIDIA Blackwell Ultra SXM | 8x NVIDIA Blackwell SXM |
| FP4 Tensor コア | 144 PFLOPS | 108 PFLOPS | 144 PFLOPS | 72 PFLOPS |
| FP8/FP6 Tensor コア | 72 PFLOPS | 72 PFLOPS |
| INT8 Tensor コア | 3 POPS | 72 POPS |
| FP16/BF16 Tensor コア | 36 PFLOPS | 36 PFLOPS |
| TF32 Tensor コア | 18 PFLOPS | 18 PFLOPS |
| FP32 | 600 TFLOPS | 600 TFLOPS |
| FP64/FP64 Tensor コア | 10 TFLOPS | 296 TFLOPS |
| メモリ合計 | 2.1TB | 1.4TB |
| NVLink | 第5世代 | 第5世代 |
| NVIDIA NVLink Switch™ | NVLink 5 スイッチ | NVLink 5 スイッチ |
| NVLink GPUからGPUへの帯域幅 | 1.8TB/s | 1.8TB/s |
| 合計NVLink帯域幅 | 14.4TB/s | 14.4TB/s |
| ネットワーク帯域幅 | 1.6TB/s | 0.8TB/s |
| 最大消費電力(TDP) | 1,100W | 1,000W |
AI とハイパフォーマンス コンピューティング向けGPU
AI、複雑なシミュレーション、膨大なデータセットは、極めて高速な相互接続を備えた複数のGPUと完全に高速化されたソフトウェア スタックを必要とします。 NVIDIA HGX™ プラットフォームは、NVIDIA GPU、NVIDIA NVLink™、NVIDIAネットワーキング、完全に最適化されたAIおよび高性能コンピューティング(HPC)ソフトウェアスタックの能力を最大限に結集し、あらゆるデータセンターに最高のアプリケーションパフォーマンスを提供し、最速で洞察を得ることができます。
技術的なブレイクスルー
AI スーパーチップの新たなクラス
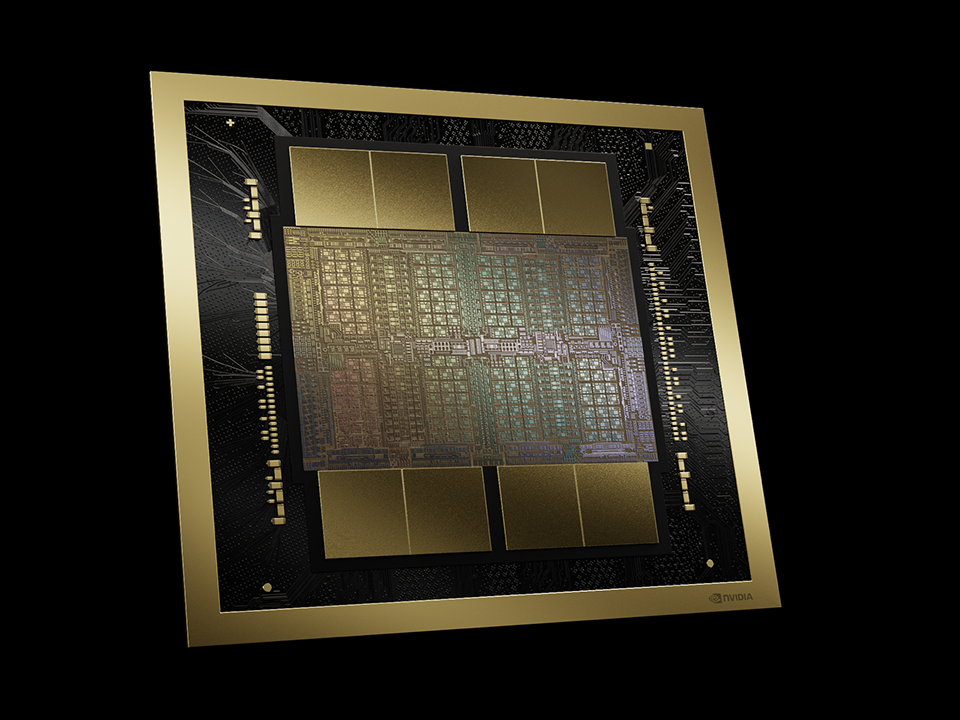
BlackwellアーキテクチャGPUは、2080億個のトランジスタを搭載し、カスタムビルドされたTSMC 4NPプロセスを使用して製造されています。すべてのBlackwell製品は、統合された単一GPUで、10テラバイト/秒 (TB/s) のチップ間相互接続によって接続された2つのレチクル限定ダイを備えています。
第 2 世代 Transformer Engine
第2世代Transformer Engineは、カスタムBlackwell Tensorコア テクノロジをNVIDIA TensorRT™-LLMおよびNeMo™ フレームワークのイノベーションと組み合わせて使用し、大規模言語モデル (LLM) と混合エキスパート (MoE) モデルの推論と学習を加速します。Blackwell Tensorコアは、新しいコミュニティ定義のマイクロスケーリング フォーマットを含む新しい精度を付加し、高い正確性を備え、さらに高い精度への容易な置き換えを実現します。
Blackwell Ultra Tensorコアは、Blackwell GPUと比較して、2倍のアテンションレイヤー アクセラレーションと、1.5倍のAIコンピューティングFLOPSを実現し強化されています。Blackwell Transformer Engine は、マイクロ テンソル スケーリングと呼ばれる細粒度のスケーリング手法を活用し、パフォーマンスと精度を最適化し、4ビット浮動小数点 (FP4) AIを実現します。これにより、高い精度を維持しながら、メモリがサポートできる次世代モデルのパフォーマンスとサイズが倍増します。
安全な AI
Blackwellには、NVIDIAコンフィデンシャル コンピューティングが導入されており、ハードウェアベースの強力なセキュリティで機密データやAIモデルを不正アクセスから保護します。Blackwellは業界初のTEE-I/O対応GPUであり、TEE-I/O対応ホストとNVIDIA® NVLink® によるインライン保護で非常に高性能なコンフィデンシャル コンピューティング ソリューションを提供します。Blackwellコンフィデンシャル コンピューティングは、暗号化なしモードと比べ、ほぼ同等のスループット パフォーマンスになります。企業は、AIの知的財産 (IP) を保護し、機密のAIトレーニング、推論、連合学習を安全な方法で可能にするだけでなく、非常に大きなモデルをパフォーマンスに優れた方法で保護できるようになりました。
NVLink および NVLink Switch
エクサスケール コンピューティングと兆単位パラメーター AIモデルの可能性を最大限に引き出すには、サーバー クラスター内の全GPU間での高速かつシームレスな通信が必要になります。第5世代のNVIDIA® NVLink® インターコネクトは最大576個のGPUまで拡張できて、パラメーターが1兆から数兆単位になるAIモデルのためにアクセラレーテッド パフォーマンスを発揮します。
NVIDIA NVLink Switch Chipは、1つの72-GPU NVLinkドメイン (NVL72) で130TB/秒のGPUの帯域幅を備えることができ、NVIDIA Scalable Hierarchical Aggregation and Reduction Protocol (SHARP)™ FP8をサポートすることで、4倍の帯域幅効率を実現します。NVIDIA NVLink Switch Chipは、1台のサーバーを超えるクラスターを同じ1.8TB/秒の驚異的な相互接続でサポートします。NVLinkを使用するマルチサーバー クラスターは、コンピューティングの増加に合わせてGPU通信を拡張します。そのため、NVL72は、単一の8基のGPUを搭載したシステムに比べて9倍のGPUスループットをサポートすることができます。
Decompression Engine
データ分析とデータベースのワークフローは従来、コンピューティングにCPUを使用していました。アクセラレーテッド データ サイエンスでは、エンドツーエンドの分析パフォーマンスを劇的に向上させ、価値創出までの時間を短縮することで、コストを削減することができます。Apache Spark を含むデータベースは、データ分析のために大量のデータを処理、加工、分析する上で重要な役割を果たします。
BlackwellのDecompresison Engineと、 NVIDIA Grace™ CPUの大量のメモリに高速リンク (毎秒900ギガバイトの双方向帯域幅) でアクセスできる機能は、データベース クエリのパイプライン全体を高速化し、かつ、LZ4、Snappy、Deflateなど最新の圧縮形式をサポートし、データ分析とデータ サイエンスで非常に高いパフォーマンスを達成します。
RAS (信頼性、可用性、保守性) エンジン
Blackwellは専用のRAS (信頼性、可用性、保守性) エンジンによるインテリジェントな回復性を備え、早期に発生する可能性がある潜在的障害を特定し、ダウンタイムを最小限に抑えます。NVIDIAのAIを活用した予測管理機能は、ハードウェアおよびソフトウェアの全体的な正常性を何千ものデータ ポイントで継続的に監視し、ダウンタイムや非効率性の発生源を予測し、阻止します。これにより、時間、電力、コンピューティング コストを節約するインテリジェントな回復性が与えられます。
NVIDIAのRASエンジンは詳しい診断情報を提供し、懸念される領域を特定し、メンテナンスを計画できます。このRASエンジンは、問題の原因を速やかに特定することでターンアラウンド タイムを短縮し、効果的な修正を促進することでダウンタイムを最小限に抑えます。